I. Polecenia i pliki diagnozujące system operacyjny.

Tradycyjnie już na początek proponuję użyć pomocy do naszego polecenia i wpisać w konsoli:
$ uname --help
Pojawiają nam się dostępne opcje, z których możemy odczytać np. numer kernela, jego wersję, nazwę hosta, itp.
Dodatkowo za pomocą opcji -a jesteśmy w stanie wszystkie te parametry wyświetlić razem.
Użyjemy do tego polecenia:
$ uname -a
I niby jest wszystko, ale jest to mało czytelne.

Dlatego warto skorzystać z tych opcji szczegółowych i wyciągnąć informację np. tylko o wersji kernela (kolor niebieski):
$ uname -v
albo o nazwie systemu operacyjnego (kolor zielony):
$ uname -o
Jak widzimy, wykorzystywanie szczegółowych opcji daje nam konkretny zwrot informacji.

Tradycyjnie już używamy pomocy do naszego polecenia i wpisujemy w konsoli:
$ lsb_release --help
Pojawiają nam się dostępne opcje, z których możemy odczytać np. numer dystrybucji, czy też jej nazwę kodową.
Dodatkowo za pomocą opcji -a jesteśmy w stanie wszystkie te parametry wyświetlić razem.
Użyjemy do tego polecenia:
$ lsb_release -a
W przeciwieństwie do polecenia uname informacje te są czytelne, ale jak ktoś chce
uzyskać tylko numer naszej dystrybucji to wystarczy użyć polecenia:
$ lsb_release -d
I wiemy już, że używamy wersji "Ubuntu 20.04.4 LTS".

Jesli chcemy wyświetlić zawartość pliku lsb-release wpisujemy w konsoli:
$ cat /etc/lsb-release
Ewentualnie możemy go edytować przy użyciu nano, używając do tego polecenia:
$ sudo nano /etc/lsb-release -a
I widzimy bardzo podobny efekt z informacją, że używamy wersji "Ubuntu 20.04.4 LTS".
II. Polecenia i pliki dotyczące podzespołów naszego komputera.

Na początku jak zawsze proponuję skorzystać z pomocy wpisując:
$ sudo lspci --help
Mamy tutaj dostepnych sporo możliwości, ale tak naprawdę najbardziej przydatną z nich jest opcja -v

Stosując opcję -v, mamy możliwość wyświetlenia szczegółowych informacji o wszystkich urządzeniach
znajdujących się w naszym systemie. Wpisujemy zatem:
$ sudo lspci -v
I otrzymujemy powyższy wynik. Korzystamy z VB, więc pamiętajmy, że na maszynie rzeczywistej niektóre wpisy wyglądają
bardziej sensownie. Ale już o urządzeniu audio możemy parę rzeczy się dowiedzieć, np. kto jest producentem, czy też
jaki sterownik jądra jest obecnie w użyciu). Natomiast jeśli chcemy uzyskać więcej szczegółowych informacji możemy
zastosować opcję -vv, a nawet -vvv

Natomiast jeśli chcemy uzyskać informacje ogólne o naszych urządzeniach PCI, to wystarczy wpisać
polecenie lspci bez żadnych opcji, ale oczywiście stosując sudo:
$ sudo lspci
Jak widać producenta naszego kontrolera dźwięku też można z tego odczytać.

Ponownie proponuję skorzystać z pomocy, tradycyjnie już wpisując polecenie z opcją --help:
$ sudo lscpu --help
Możemy przeanalizować dostępne opcje i zastosować właściwy parametr, ale tak naprawdę do uzyskania
jakiejś informacji o naszym procesorze w zupełności wystarczy samo polecenie bez żadnych opcji.

Dlatego chcąc uzyskać informacje dotyczące np. ilości rdzeni procesora, albo prędkości zegara
(taktowanie) wystarczy wpisać:
$ sudo lscpu
Oczywiście zwrot szczegółowych informacji o naszym procesorze jest nieco zakłamany ponieważ
pracujemy na wirtualnej maszynie, ale do celów dydaktycznych powinno nam to wystarczyć.

Właściwie to podobnie jak wcześniej powinienem odesłać wszystkich do skorzystania z pomocy, ale tym razem zaczniemy
od zastosowania polecenia bez żadnych opcji. Wpisujemy zatem:
$ sudo lshw
Otrzymujemy bardzo szczegółową informację o sprzęcie znajdującym się w naszym systemie i tak naprawdę możemy
tu znaleźć wszystko, ale trzeba to sobie odszukać. Nie jest to takie proste, ponieważ musimy pamiętać, że pracujemy
w trybie tekstowym i widzimy tylko samą koncówkę informacji zwróconych przez powyższe polecenie.

Warto więc skorzystać z polecenia less, które umożliwia wyświetlanie informacji "ekranami" z
możliwością nawigacji. Składnia takiego polecenia powinna wyglądać następująco:
$ sudo lshw | less
Teraz spokojnie możemy używać strzałek, spacji bądź entera do
poruszania się po naszej konsoli. Na początku mamy tylko takie ogólne informacje (np. o procesorze lub pamięci), a
te bardziej szczegółowe należy odszukać w dalszej części zwróconych informacji.

Niemniej jednak warto z samej pomocy skorzystać, ponieważ są tam opcje, za pomocą których można sobie trochę ułatwić
życie. Wpisujemy zatem:
$ sudo lshw --help
Mamy tutaj między innymi taką podpowiedź, że możemy sobie wyeksportować informacje do plików typu html
lub xml, ale w trybie tekstowym zbyt wiele nie zyskamy.
Dlatego w tym przypadku tak naprawdę najlepiej skorzystać z opcji -short lub -businfo.

Wykorzystamy więc opcję -short. Wpisujemy zatem:
$ sudo lshw -short
Używając tego polecenia otrzymujemy takie skrócone informacje o naszym sprzęcie.

Oczywiście możemy sobie przekierować wynik tego polecenia do konkretnego pliku, w naszym przypadku będzie to plik sprzet.txt. Wystarczy użyć polecenia:
$ sudo lshw -short > sprzet.txt
Następnie korzystając z polecenia cat możemy wyświetlić zawartość pliku sprzet.txt. Całe polecenie będzie miało postać:
$ cat sprzet.txt
Nie podaję pełnej ścieżki do tego pliku, ponieważ jestem w katalogu domowym użytkownika highsec, w tym miejscu został on utworzony, więc możemy zastosować
ścieżkę względną do tego pliku. Ważną rzeczą po przeglądnięciu zawartości tego pliku jest kolumna class.

W większości przypadków potrzebujemy konkretnego zwrotu informacji np. o pamięci RAM, a nie przeglądać wszystkie wpisy dotyczące naszych podzespołów. Dlatego
wybieramy konkretny komponent widoczny w kolumnie class i wykorzystując parametr -c, sprawdzamy go. Wystarczy użyć polecenia:
$ sudo lshw -c memory
Efekt polecenia widoczny jest powyżej i nie musimy już przeglądać wszystkich danych, żeby dowiedzieć się ile mamy RAM-u w systemie (u nas 4GB). Oczywiście taką składnię
stosujemy do dowolnego komponentu, który w danej chwili nas interesuje.

Możemy także odfiltrować sobie konkretną informację, np. rozmiar pamięci, używając polecenia grep. Spowoduje ono wypisanie całej linijki, która
zawiera konkretny ciąg znaków np. "size". Parametr -i jest po to, aby zignorować wielkość liter. Wystarczy użyć polecenia:
$ sudo lshw -c memory | grep -i size
I mamy tylko wpisy zawierające ciąg znaków "size" czyli dysponujemy 4 GB RAM-u.

Oczywiście również możemy sobie przekierować odfiltrowany wynik tego polecenia do konkretnego pliku, w naszym przypadku będzie to plik ram.txt. Wystarczy użyć polecenia:
$ sudo lshw -c memory | grep -i size > ram.txt
Aby sprawdzić, czy faktycznie efekt naszego polecenia znalazł się w pliku, wystarczy wpisać:
$ cat ram.txt
I wszystko się zgadza.

Należy pamiętać, że użycie znaku ">" spowoduje utworzenie nowego pliku lub nadpisanie zawartości w już istniejącym pliku. Natomiast jeśli chcielibyśmy dodać coś do naszego pliku
ram.txt to należy ">>". Załóżmy, że chcemy dopisać do pliku ilość rdzeni naszegoi procesora. Wystarczy użyć polecenia:
$ sudo lscpu | grep -i core >> ram.txt
I jeszcze sprawdzamy poleceniem:
$ cat ram.txt
I wszystko się zgadza.

Można jeszcze "ładnie" rozdzielić te informacje o pamięci od informacji o rdzeniach procesora. Wykorzystamy to tego polecenie echo. Wpisujemy więc:
$ sudo echo "-------------------------------------------" >> ram.txt
I jeszcze sprawdzamy poleceniem:
$ cat ram.txt
Prawie dobrze, z tym małym wyjątkiem, że nasza linia dodana została na końcu. Poprawimy więc nasze wpisy wykonując w odpowiedniej kolejności wszystkie polecenia:
$ sudo lshw -c memory | grep -i size > ram.txt
$ sudo echo "-------------------------------------------" >> ram.txt
$ sudo lscpu | grep -i core >> ram.txt
I ponownie sprawdzamy poleceniem:
$ cat ram.txt
Teraz jest wszystko jak należy.

Wprawdzie ten plik nie zawiera takich informacji jak producent pamięci, czy też jej numer seryjny, ale za to mamy wpisy mówiące o tym ile tej pamięci jest, ile jest dostepnej,
wolnej itp. Wpisujemy zatem polecenie:
$ cat /proc/meminfo
I już widzimy, że faktycznie dysponujemy 4 GB RAM-u, a dostępnej obecnie pamięci jest około 3,5 GB.

Tym razem, tradycyjnie już, na początku proponuję skorzystać z pomocy. Wpisujemy zatem polecenie:
$ free --help
Jak widać na powyższym screenie kilka opcji do wyboru mamy. Jedną z nich jest wykorzystanie parametru -h.

Ta opcja w dosłownym tłumaczeniu "pokazuje dane wyjściowe czytelne dla człowieka". Wpisujemy zatem polecenie:
$ free -h
I widzimy, że dysponujemy prawie 4GB RAM-u (3,8Gi - przypomina to raczej jednostkę "gibi"). Gdybyśmy wpisali samo polecenie free, to uzyskamy podobny wynik, tyle, że
przedstawiony w kilobajtach.

Program top jest narzędziem bardzo prostym i dostępnym niemal we wszystkich systemach uniksopodobnych. Aby go uruchomić wystarczy wpisać w konsoli:
$ top
Efekt tego polecenia nie jest jakoś wizualnie powalający, a sam "interfejs" może być dla niektórych nawet nieczytelny. Niemniej jednak z powyższego screena możemy np. odczytać, że zalogowany w systemie
jest obecnie 1 użytkownik, system działa od 2 minut, jest 96 procesów, z których uruchomiony jest 1, a uśpionych
jest 95, zaś dostępnej pamięci mamy około 3,5GB. Widzimy też, że numer PID programu top ma wartość 979.

Natomiast nieco bardziej przejrzystym programem jest htop, który coraz częściej jest dostępny domyślnie w niektórych dystrybucjach bez potrzeby instalacji. Aby
go uruchomić wystarczy wpisać w konsoli:
$ htop
Jak widzimy, sam interfejs jest zdecydowanie bardziej czytelny, a oprócz tego dochodzą tutaj opcje związane z zabijaniem procesów (F9), podnoszeniem (F8) lub obniżaniem (F7) priorytetu
procesu itp. Również możemy sobie filtrować (F4) procesy oraz dostosować ustawienia do własnych potrzeb (F2).

Dosyć ciekawą opcją, jest możliwość wyświetlenia powiązanych ze sobą procesów, w formie "drzewa" używając klawisza F5. Widzimy na powyższym screenie, w jaki sposób jest
uruchomiona i powiązana nasza obecna sesja.

Spróbujemy teraz nieco bardziej obciążyć nasz procesor i uruchomić kilka konsoli. Zalogujemy się także drugim użytkownikiem oraz odpalimy kilka dodatkowych zadań. Zastosujemy
w konsoli polecenie:
$ w
Na powyższym screenie widzimy kto jest obecnie zalogowany oraz jakie zadania są uruchomione w poszczególnych konsolach.

Teraz widzimy wyraźnie w jaki sposób uruchomione dodatkowe procesy wpływają na obciążenie procesora i zużycie pamięci.

Teraz wybierzemy sobie (wystarczy go zaznaczyć) proces o numerze PID 1539, czyli ping elektronik.rzeszow.pl i zwyczajnie go wyłączymy (zabijemy), używając klawisza F9. Na koniec potwierdzimy
Enterem i zostanie wysłany sygnał (Send signal) do zamknięcia procesu.

Przechodzimy następnie do konsoli nr 4, i sprawdzamy czy nasz proces został zakończony. Komunikat Terminated mówi nam jasno, że proces został zakończony.

Jeśli wspomnieliśmy już o sprawdzaniu zalogowanych użytkowników w systemie, to warto wspomnieć o takich poleceniach jak:
- users - wyświetla nazwy użytkowników, którzy są aktualnie zalogowani
- who - wyświetla aktualnie zalogowanych użytkowników, łącznie z terminalami których używają
- whoami - wyświetla informacje o aktualnie zalogowanym użytkowniku

Na początku jak zawsze proponuję skorzystać z pomocy, pamiętając o stosowaniu sudo. Wpisujemy więc:
$ sudo dmidecode --help
Mamy tutaj dostepnych trochę opcji, ale tak naprawdę najbardziej przydatną z nich jest opcja -t.

Wpisując parametr -t ponownie skorzystamy z pomocy. Wpisujemy więc:
$ sudo dmidecode -t --help
Jak widać mamy dostępnych kilka sekcji czy też typów, które możemy sobie szczegółowo wyświetlić. My wyciągniemy trochę informacji o płycie głównej.

Wykorzystamy do tego typ baseboard. Wpisujemy więc:
$ sudo dmidecode -t baseboard
Pojawiają nam się szczegółowe informcje, ale pamiętajmy, że ja pracuję na "wirtualce" więc to są trochę mało precyzyjne dane. W systemie rzeczywistym wygląda to zupełnie inaczej.
III. Zmiana ustawień i parametrów konta użytkownika.
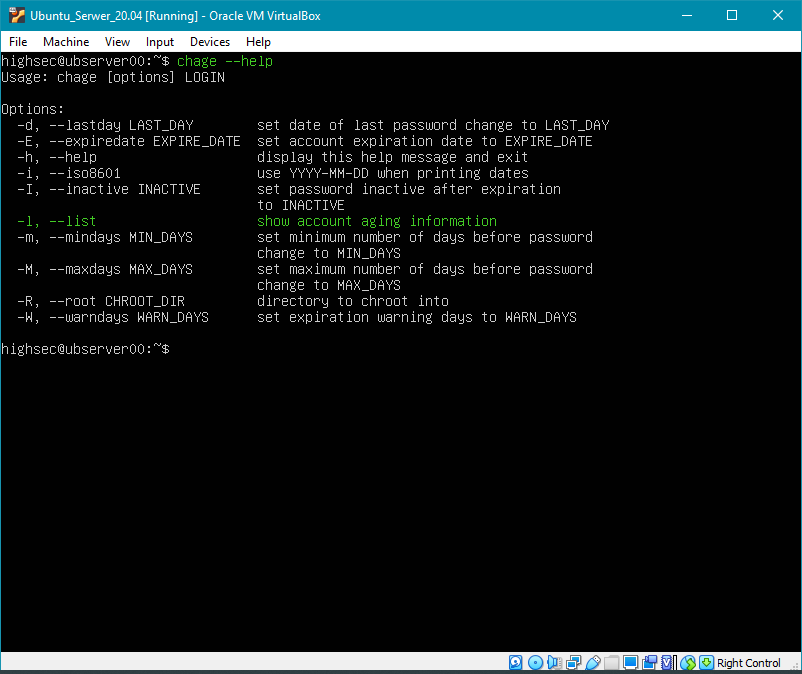
Najpierw spróbujemy wykorzystać polecenie chage. Żeby sprawdzić
jakie daje nam możliwości warto skorzystać z podpowiedzi. Wpisujemy więc:
$ chage --help
Pojawia nam się lista dostępnych opcji, które możemy użyć razem z tym poleceniem. Na początek wykorzystamy
parametr -l, który wyświetla nam informacje o statusie konta.
IV. Uprawnienia w Linuksie.
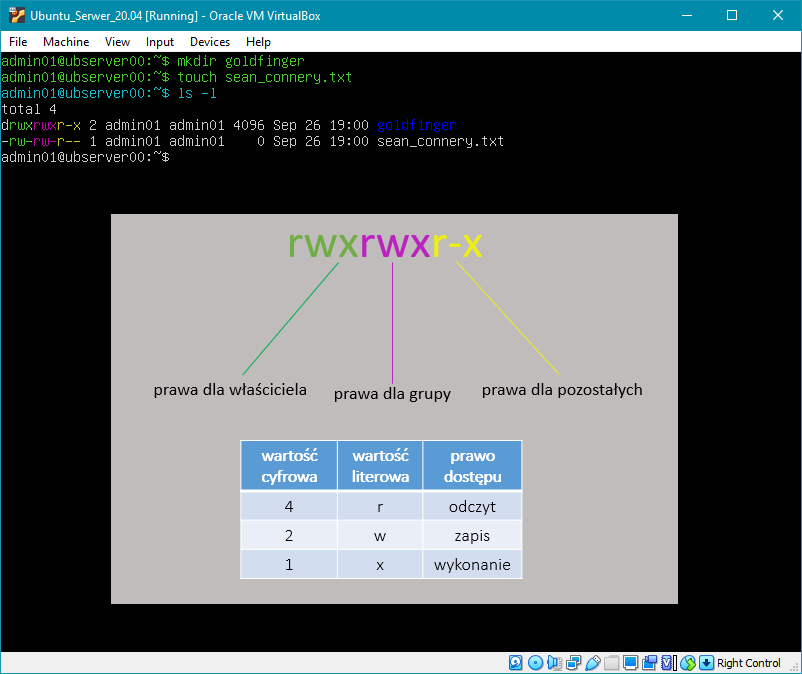
Aby lepiej zrozumieć jak funkcjonują uprawnienia w Linuksie,
utworzymy sobie jeden katalog o nazwie goldfinger oraz plik
sean_connery.txt. Wpisujemy polecenia:
$ mkdir goldfinger
$ touch sean_connery.txt
Następnie wyświetlamy sobie zawartość naszego katalogu domowego i widzimy, że utworzony folder
domyślnie ma uprawnienia 775 (rwxrwxr-x), natomiast plik
664 (rw-rw-r--). Na powyższym screenie podaję wykaz pojedynczych uprawnień zarówno
w wartościach cyfrowych (a dokładnie w systemie ósemkowym) jak i literowych. Oczywiście prawa dostępu
można łączyć i stąd rwx po zsumowaniu daje wartość 7,
a r-x daje wartość 5. Widzimy również, że pierwszy bit przy folderze
ma literkę "d", a przy pliku jest "-". Kolejne trzy bity dotyczą uprawnień dla właściciela
(user-owner), następne trzy bity to uprawnienia dla grupy (group), a ostatnie
trzy to uprawnienia dla pozostałych użytkowników (others).
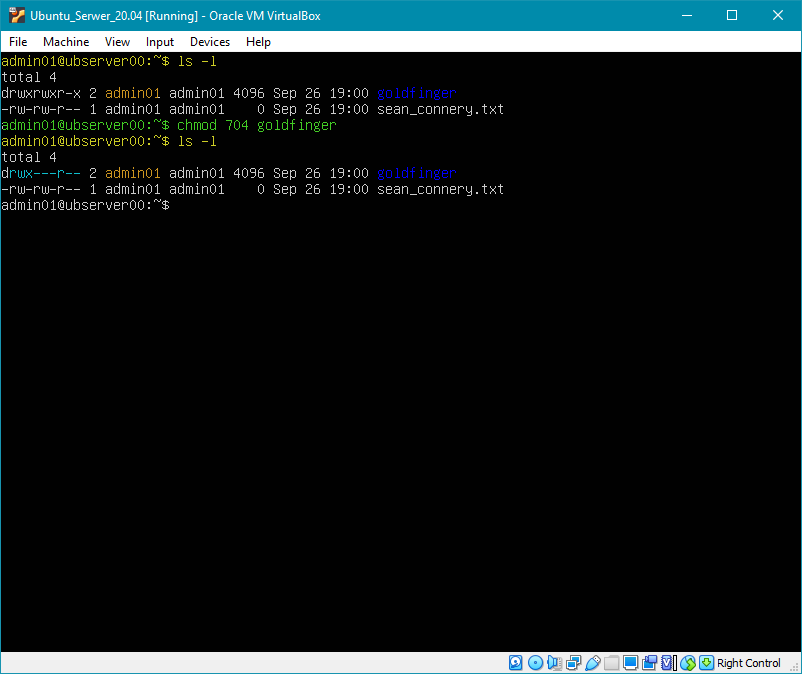
Załóżmy, że chcemy nadać do katalogu goldfinger pełne
prawa dla właściciela (7), odebrać uprawnienia dla grupy (0), a dla pozostałych użytkowników
nadać możliwość odczytu (4). Użyjemy do tego polecenia:
$ chmod 704 goldfinger
Nie musimy używać sudo ponieważ jesteśmy zalogowani użytkownikiem admin01,
który jest właścicielem tego katalogu (kolor pomarańczowy). Następnie sprawdzamy uprawnienia:
$ ls -l
I widzimy, że uprawnienia są już zmienione (kolor jasny niebieski).
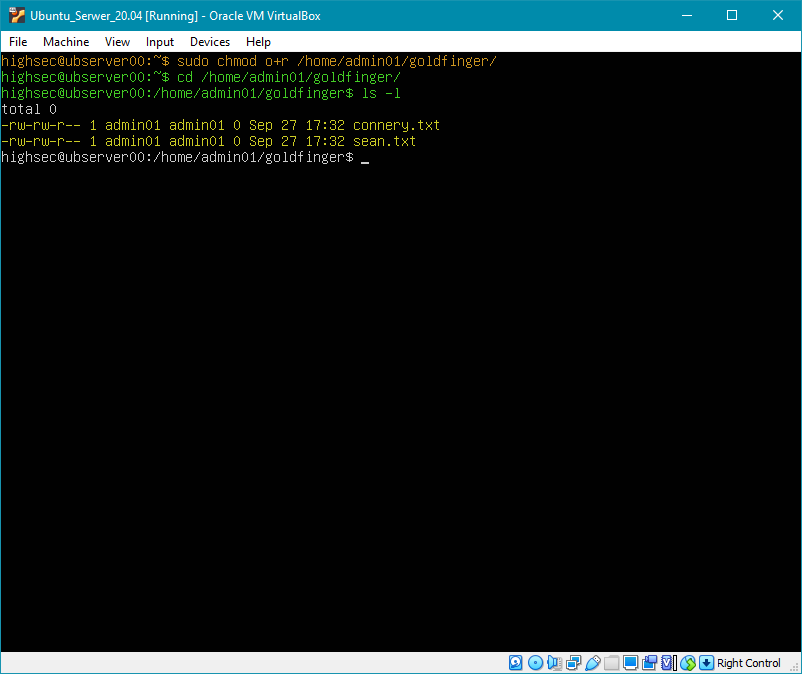
Dlatego, aby wejść do katalogu i mieć możliwość podglądnięcia jego zawartości należy
te dwa prawa (odczyt i wykonanie) ustawić jednocześnie. Wykonanie już mamy, więc dodamy tylko odczyt poleceniem:
$ sudo chmod o+r /home/admin01/goldfinger
Ponownie przechodzimy do katalogu i próbujemy podglądnąć jego zawartość. Teraz już wszystko działa.
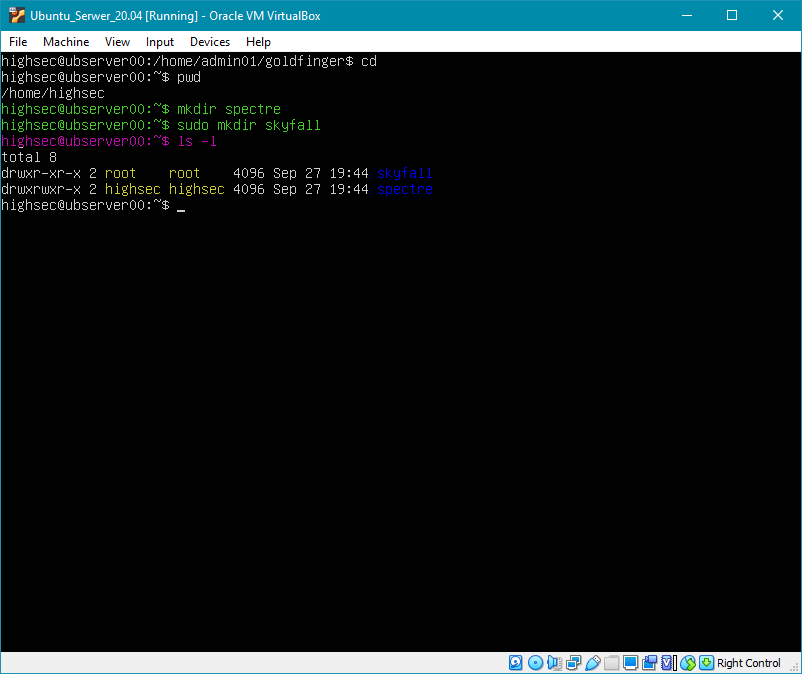
Będąc zalogowanym użytkownikiem highsec, przejdziemy
do jego katalogu domowego i utworzymy w nim dwa nowe foldery skyfall oraz spectre.
Jeden utworzymy bez, a drugi z użyciem polecenia sudo. Wpisujemy zatem:
$ mkdir skyfall
$ mkdir spectre
I znanym już poleceniem ls -l sprawdzamy kto jest ich właścicielem. Oczywiście
potwierdziło się to co napisałem wcześniej. W takim razie zmienimy właściciela katalogu
skyfall z root na highsec.
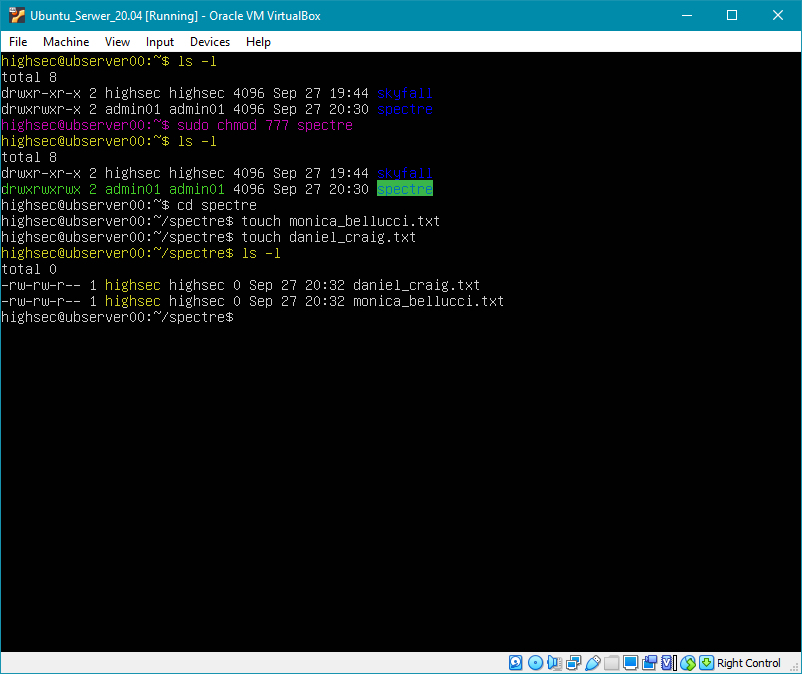
Aby zrozumieć działanie lepkiego bitu, nadamy
do katalogu spectre pełne prawa dla wszystkich użytkowników. Wpisujemy zatem:
$ sudo chmod 777 spectre
Jak zawsze w takiej sytuacji wylistujemy sobie poleceniem ls -l i widzimy, że
jego właścicielem jest admin01, a wszyscy użytkownicy mają pełne prawa dostępu do
tego katalogu. Następnie przejdziemy do tego katalogu i bedąc zalogowanym użytkownikiem highsec
utworzymy w nim dwa pliki:
$ touch daniel_craig.txt monica_bellucci.txt
Poleceniem ls -lsprawdzamy zawartość tego katalogu i widzimy, że te pliki się tam znajdują.
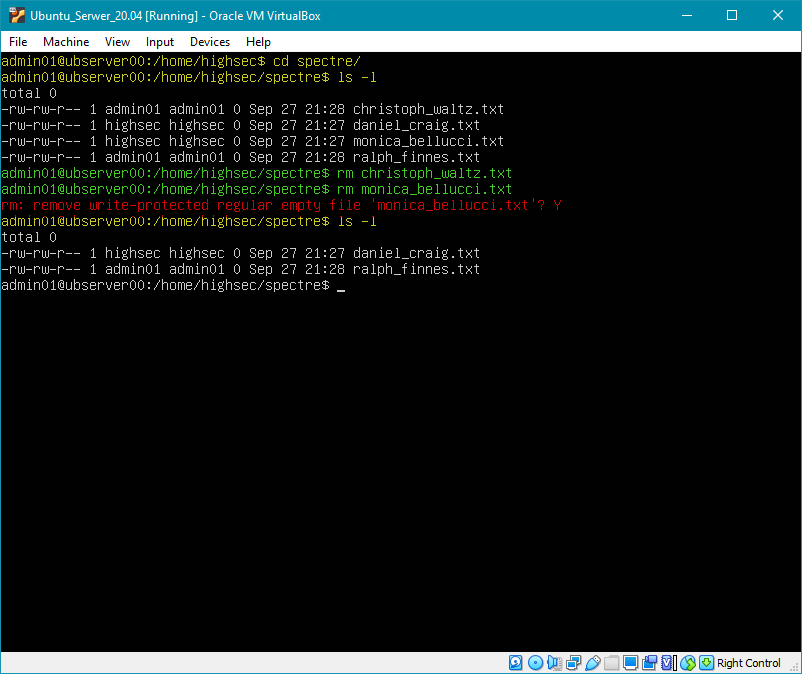
Z poziomu użytkownika admin01 próbujemy usunąć dwa pliki (jeden swój, a drugi
użytkownika highsec) za pomocą poleceń:
$ rm monica_bellucci.txt
$ rm christoph_waltz.txt
Sprawdzamy zawartość poleceniem ls -l i widzimy, że obydwa pliki zostały usunięte.
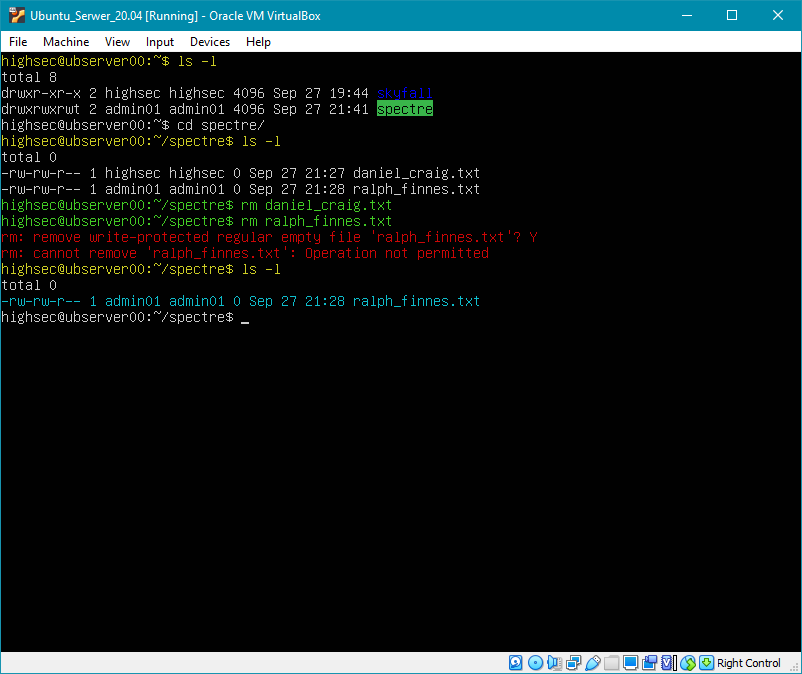
Teraz logujemy się użytkowniem highsec i próbujemy usunąć kolejne dwa pliki
(jeden swój, a drugi użytkownika admin01) za pomocą poleceń:
$ rm ralph_finnes.txt
$ rm daniel_craig.txt
Jak widać jeden z plików nie dał się usunąć, a był to plik użytkownika admin01.
Sprawdzamy jeszcze zawartość katalogu poleceniem ls -l i widzimy, że ten plik
pozostał. Tak właśnie działa lepki bit.
V. Dowiązanie (link) twarde i symboliczne.
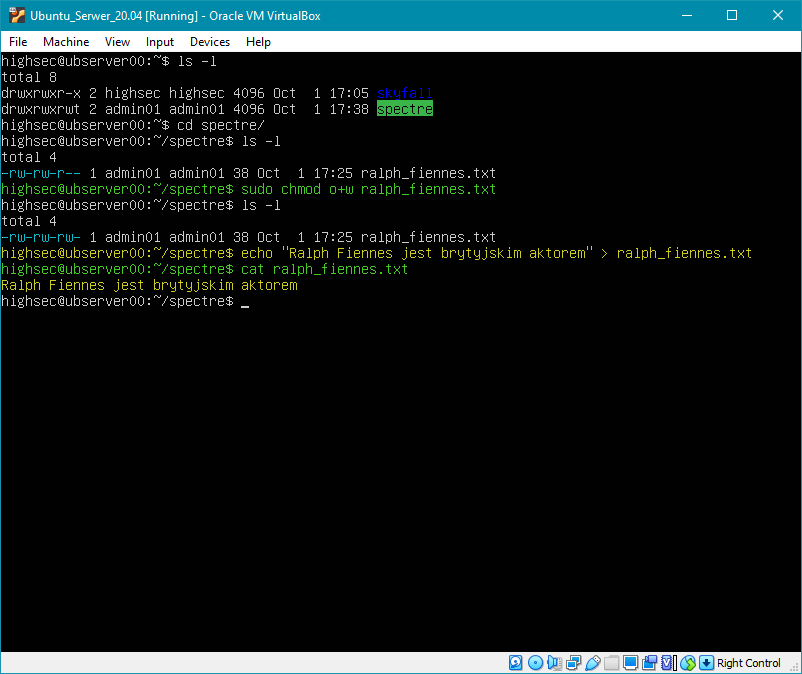
W katalogu domowym użytkownika highsec mamy katalog
spectre, a w nim plik ralph_fiennes.txt. Najpierw ustawimy
sobie dla niego możliwość zapisu dowolnym użytkownikiem korzystając z polecenia:
$ sudo chmod o+w ralp_fiennes.txt
A następnie wprowadzimy do niego zawartość "Ralph Fiennes jest brytyjskim aktorem". Użyjemy do tego polecenia:
$ echo "Ralph Fiennes jest brytyjskim aktorem" > ralph_fiennes.txt
Oczywiście możemy sprawdzić, czy nasze zdanie zostało wprowadzone do naszego pliku. Użyjemy
polecenia:
$ cat ralph_fiennes.txt
Widzimy, że wszystko jest ok i plik zawiera wprowadzone przez nas zdanie.
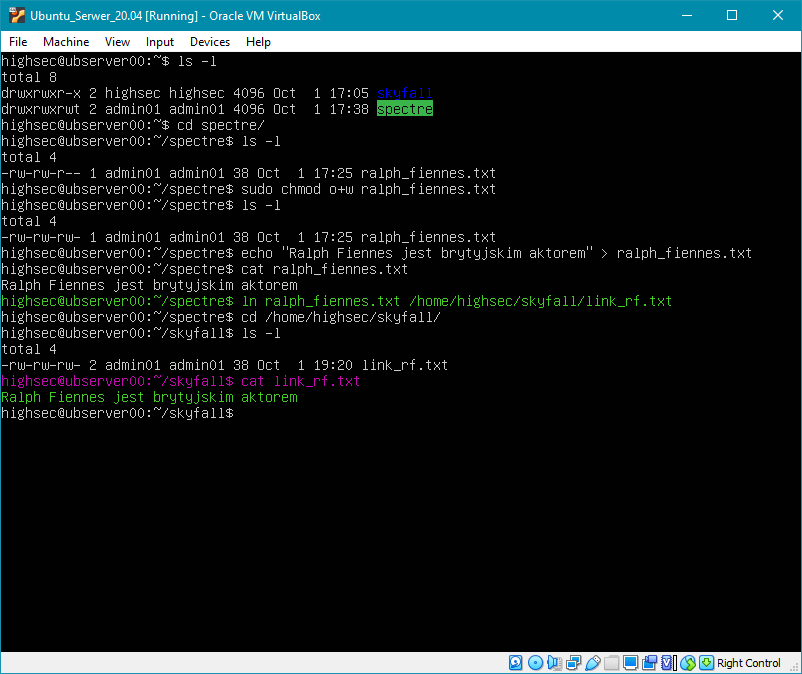
Teraz utworzymy dowiązanie twarde, do którego zastosujemy polecenie ln.
Ogólnie składnia wygląda następująco: ln plik_do_którego_tworzymy_dowiązanie nazwa_dowiązania.
Stworzymy teraz dowiązanie twarde do pliku ralph_fiennes.txt i umieścimy je pod nazwą
link_rf.txt w katalogu skyfall. Wpisujemy polecenie
$ ln ralph_fiennes.txt /home/highsec/skyfall/link_rf.txt
Następnie przechodzimy do katalogu skyfall i widzimy, że nasze dowiązanie już
się tam znajduje. Podglądamy jego zawartość poleceniem cat i wszystko się zgadza. Co ciekawe
jeśli naniesiemy jakieś zmiany w tym dowiązaniu, to zostaną one również wprowadzone w pliku oryginalnym.
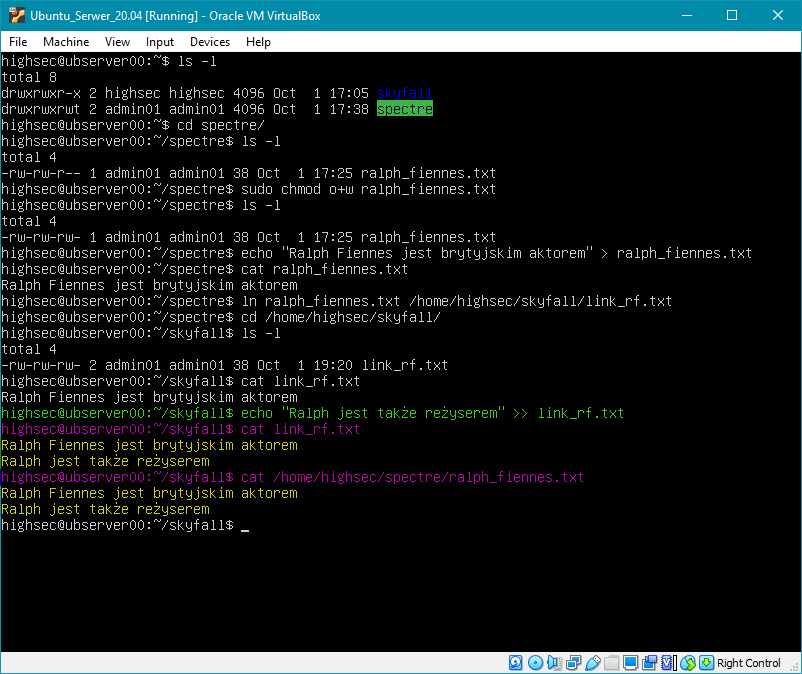
Dodamy więc kolejne zdanie do naszego dowiązania:
$ echo "Ralph jest także reżyserem" >> link_rf.txt
Następnie podglądamy jego zawartość poleceniem cat i wszystko się zgadza.
Sprawdzimy jeszcze zawartość pliku ralph_fiennes.txt tym samym sposobem i widzimy, że
to zdanie znajduje się również w pliku oryginalnym.
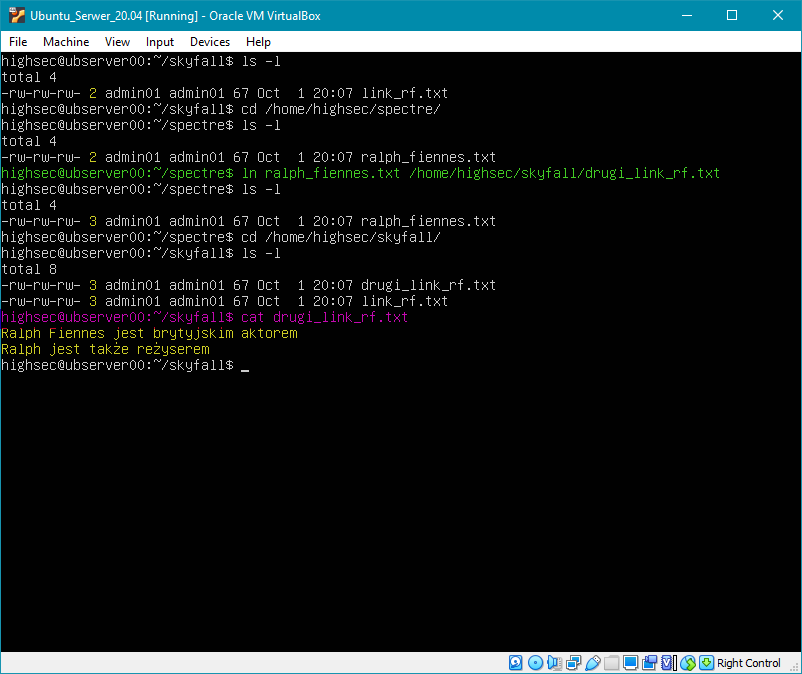
Jest jeszcze jedna rzecz, o której warto wspomnieć. Gdy używamy polecenia
ls -l to po uprawnieniach widzimy wartość 2. Oznacza to, że w systemie
znajdują się dwa pliki z tą samą zawartością (powiązane ze sobą). Gdy stworzymy kolejne dowiązanie do
pliku ralph_fiennes.txt, to powinna pojawić nam się w tym miejscu wartość 3.
Wpisujemy więc:
$ ln ralph_fiennes.txt /home/highsec/skyfall/drugi_link_rf.txt
Następnie sprawdzamy poleceniem ls -l czy wartość 3 pojawiła się w odpowiednim
miejscu. Oczywiście tak się stało. Przechodzimy zatem do katalogu skyfall, także podglądamy
jego zawartość i widzimy, że kolejne dowiązanie zostało utworzone. Dodatkowo wartość 3 pojawiła
się przy obydwu plikach.
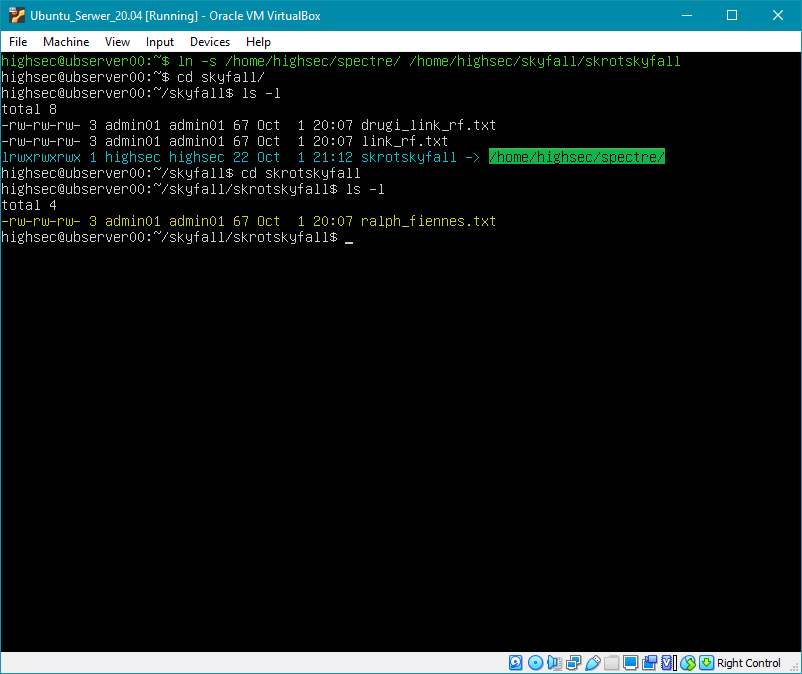
Utworzymy dowiązanie symboliczne, do którego zastosujemy polecenie ln -s.
Ogólnie składnia wygląda następująco: ln -s plik/katalog_do_którego_tworzymy_dowiązanie nazwa_dowiązania.
Niech to będzie dowiązanie symboliczne do katalogu spectre i umieścimy je katalogu
skyfall pod nazwą skrotskyfall. Użyjemy do tego polecenia:
$ ln -s /home/highsec/spectre /home/highsec/skyfall/skrotskyfall
Przechodzimy do katalogu skyfall, podglądamy jego zawartość i widzimy, że dowiązanie już tam się
znajduje. Wystarczy teraz użyć polecenia:
$ cd skrotskyfall
I jeszcze klasycznego ls -l i widzimy zawartość katalogu spectre.